Eine Kategorie in 265 ms: unser Kategorisierer mit Jev
Eine Zahlung kommt rein, Jev schlägt eine Kategorie vor. So haben wir im kleinen Entwicklungstest 265 ms im Median erreicht und nehmen frühere Kundenkorrekturen zur nächsten Entscheidung mit.
- Kategorie
- Allgemein
- Aktualisiert
- Autor:in
- Stan Kharlap
Eine Zahlung kommt rein. Da stehen ein Empfänger, ein Betrag und mit etwas Glück ein paar hilfreiche Wörter im Verwendungszweck. Jetzt fehlt noch die Kategorie. Eine kleine Aufgabe, die beim Bankimport immer wieder anfällt.
Seit dem 25. September 2026 nutzen wir Jev für die Kategorisierung im Produktivbetrieb. In einem kleinen Entwicklungstest mit erfundenen Zahlungen kamen wir auf 265 ms im Median und einen p95 von 302 ms. Alle 30 Anfragen lieferten eine Kategorie aus der Liste, die wir mitgeschickt hatten.
So haben wir das gebaut: Jev bekommt klare Auswahlmöglichkeiten, unsere bisherigen Buchungsanweisungen und ein paar passende frühere Entscheidungen des Kunden. Dazu kommt eine Ersatzlösung, damit auch bei einem schwer verständlichen Verwendungszweck ein Vorschlag da ist.
Jev eine klare Aufgabe geben
Jev ist das Entscheidungsmodell von TypeSafe. Seine Choice-Funktion bekommt Optionen und wählt eine davon aus. Das passt gut: Der Kontenplan steht schon, wir brauchen eine Kategorie daraus. Mehr zu Jev.
Unser Code stellt die Liste vor dem Modellaufruf zusammen. Kategorien müssen aktiv sein, zur Firma und zum Kontentyp gehören und zur Zahlungsrichtung passen. Wo vorgesehen, können auch passende Eigenkapitalkonten dabei sein. Jev bekommt außerdem Empfänger, Verwendungszweck, Betrag und etwas Kontext zum Unternehmen.
Die grundlegenden Buchungsanweisungen nehmen wir aus unserem bisherigen Kategorisierer mit: Transaktionsbeispiele, Hinweise zu Anbietern und die aktuelle Klassifizierungsanweisung. In diesem Prompt steckt schon nützliches Wissen. Wir behalten es und lassen Jev eine der angebotenen Kategorien wählen.

Den Weg zur Antwort kurz halten
Zuerst prüfen wir die ausdrücklichen Buchungsregeln. Auch ein passendes Lieferantenmuster, das der Kunde wiederholt bestätigt hat, kann die Kategorie direkt liefern. Dafür brauchen wir keinen Modellaufruf.
Diese Abkürzung hat Grenzen. Ein Verwendungszweck kann erklären, was tatsächlich gekauft wurde. Und derselbe Lieferant kann in der Historie unter mehreren Kategorien auftauchen. In beiden Fällen lassen wir den gesamten Kontext in die Auswahl einfließen.
Für jede Zahlung, die bei Jev landet, senden wir eine direkte Anfrage an TypeSafe. Den HTTP-Client verwenden wir wieder. Kategorien und Historie laden wir einmal pro Importgruppe; die passenden Beispiele suchen wir für jede Zahlung neu heraus. Pro Transaktion bleibt es bei einer eigenen Modellanfrage.
Kommt die Antwort zurück, prüfen wir die Kategorie-ID gegen unsere Liste. Das Anfrageformat steht in der TypeSafe-API-Dokumentation. Die Grundidee im Code sieht so aus:
options = eligible_categories(
    company, direction,
)
examples = relevant_choices(
    payment, limit=5,
)
choice = jev_choose(
    payment, options, examples,
)

if choice in options:
    return choice
return general_category(options)
Regeln, Tracing und Fehlerbehandlung sind hier der Kürze halber ausgelassen. Zur Ersatzkategorie kommen wir gleich.
Ein Lieferantenname verrät nicht alles
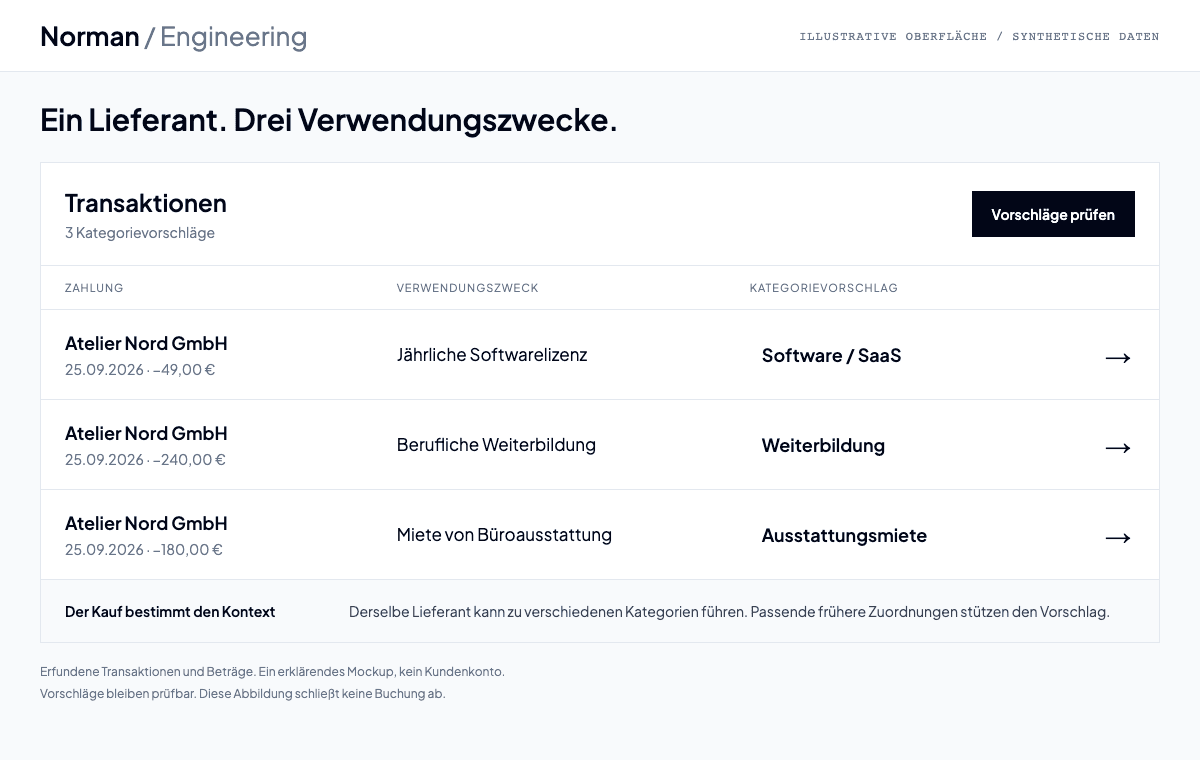
Nehmen wir die erfundene Atelier Nord GmbH. Eine Rechnung betrifft eine Softwarelizenz, die nächste eine Weiterbildung, die dritte gemietete Ausstattung. Derselbe Lieferant, drei verschiedene Käufe. Wer sich nur die letzte Kategorie für diesen Namen merkt, kann bei der nächsten Zahlung leicht danebenliegen.
Kundenkorrekturen haben wir bereits gespeichert. Dazu kommen Kategorieänderungen im Änderungsprotokoll. Daraus suchen wir hilfreiche Beispiele für die nächste Anfrage. Jedes Beispiel muss zur selben Firma und Zahlungsrichtung gehören. Die gespeicherte Entscheidung muss noch zur aktuellen Kategorie der Transaktion passen, und diese Kategorie muss in der erlaubten Liste stehen.
Treffer im Verwendungszweck gewichten wir stärker als Treffer im Lieferantennamen. Datumsangaben, Referenznummern und übliche Bankfloskeln entfernen wir vor dem Vergleich. Bei klar unterschiedlichen Zwecken reicht ein gleicher Lieferantenname nicht aus, um die Zahlungen als Beispiele füreinander zu verwenden.
Bis zu fünf passende Beispiele kommen in den Prompt. Finden wir weniger, schicken wir weniger. Die Suche arbeitet momentan mit Wörtern und kann deshalb Synonyme oder Übersetzungen übersehen. Da haben wir einen konkreten Ansatz für die nächste Verbesserung.
Die Grundlage haben wir im Beitrag zum Firmengedächtnis beschrieben. Diese Version wählt genauer aus, welche früheren Entscheidungen sie mitnimmt. Eine neue gespeicherte Korrektur kann schon der nächsten Anfrage helfen: Der Kontext wird aktualisiert, die Modellgewichte bleiben gleich.
Einen Vorschlag zum Weiterarbeiten liefern
Eine leere Kategorie lässt die ganze Arbeit beim Kunden. Wir möchten einen Ausgangspunkt anbieten, den man prüfen und bei Bedarf ändern kann, auch wenn der Verwendungszweck wenig hergibt.
Sind KI-Vorschläge aktiviert und gibt es mindestens eine zulässige Kategorie, übernehmen wir eine gültige Jev-Auswahl auch bei niedriger Wahrscheinlichkeit. Bei einer ungültigen Antwort, einem Timeout oder einem API-Ausfall wählt unser Code lokal eine Ersatzkategorie. Bevorzugt wird die allgemeine Ausgaben- oder Einnahmenkategorie des Kontenplans. Ist die Liste leer, muss zuerst die Konfiguration korrigiert werden.
Unsichere Antworten und Ersatzentscheidungen kennzeichnen wir im Trace getrennt. TypeSafe liefert eine Auswahlwahrscheinlichkeit und ein Confidence-Signal; der Confidence-Leitfaden erklärt beide. Diese Signale helfen uns bei der Analyse. Die tatsächliche Buchungsgenauigkeit messen wir separat.
Das Ergebnis bleibt ein Vorschlag, den Kunden prüfen und ändern können. Umsatzsteuer und Abschluss der Buchung sind eigene Schritte. Regeln mit Prüfpflicht behalten Vorrang, und deaktivierte KI-Automatisierung bleibt deaktiviert.
Woher die 265 ms kommen
Am 25. September 2026 haben wir sechs erfundene Ausgabenfälle je fünfmal mit jev-1.13.0 durchlaufen lassen. Jede Anfrage hatte 68 Kategorien zur Auswahl. Die Aufrufe liefen nacheinander vom Entwicklungsbackend, die Reihenfolge der Fälle wechselte pro Runde.

| Messgröße | Ergebnis |
|---|---|
| Mediane Adapterzeit | 265 ms |
| p95 nach Nearest-Rank-Methode | 302 ms |
| Langsamster Aufruf | 791 ms |
| HTTP-200-Antworten | 30 von 30 |
| Zulässige Kategorien zurückgegeben | 30 von 30 |
Der erste Aufruf war mit 791 ms der langsamste und zählt mit. HTTP-Verbindungen wurden wiederverwendet, die Historie lag im Speicher, Trace-Schreibzugriffe waren ausgeschaltet. Der Timer umfasst Prompt-Aufbau, Auswahl der Beispiele und API-Aufruf samt Netzwerk. Browser, Bankimport, OCR, Datenbankabruf der Historie und Speicherung der Transaktion liegen außerhalb.
Das ist eine kleine Momentaufnahme aus der Entwicklung mit wiederholten Eingaben. Das Caching beim Anbieter haben wir nicht kontrolliert. Sie zeigt die Geschwindigkeit dieses Bausteins; Produktionslatenz, Verhalten unter Last und Vergleiche mit anderen Produkten brauchen eigene Tests. Die Rohdaten und Methode sind verfügbar.
Prüfen, ob es besser wird
Alle sechs Fälle bekamen in diesem Lauf die erwarteten Kategorien. Um zu sehen, wie gut das auf Kundenzahlungen übertragbar ist, brauchen wir unabhängige Beispiele mit geprüften Antworten.
Wir betrachten zwei Werte getrennt: Abdeckung, also wie oft eine Kategorie zur Prüfung da ist, und Übereinstimmung mit der geprüften Antwort. Der erste Wert zeigt, ob der Ablauf weitergeht. Der zweite zeigt, wie hilfreich die Vorschläge sind.
Unsere Auswertung lässt denselben Fall mit und ohne Historie durchlaufen. Testtransaktionen bleiben aus allen Prompts draußen. Beispiele müssen vor der geprüften Zahlung bestätigt worden sein. Später bearbeitete Datensätze und Lieferantenzusammenfassungen ohne verlässliches Datum bleiben ebenfalls draußen. Sonst geben wir dem Modell womöglich versehentlich die Lösung mit und freuen uns über das tolle Ergebnis.
In unserer aktuellen Entwicklungsstichprobe bleibt nach diesen Filtern keine unabhängige frühere Historie übrig. Einen gemessenen Genauigkeitsgewinn können wir daher noch nicht nennen. Das ist der nächste Schritt. Bisher haben wir einen schnellen Vorschlag, frühere Kundenentscheidungen als Kontext und eine Möglichkeit zu prüfen, ob die nächsten Änderungen die Vorschläge wirklich verbessern.
Häufige Fragen
- Wie schnell geht das?
- Unser kleiner Entwicklungstest am 25. September 2026 kam bei 30 Aufrufen auf 265 ms im Median und 302 ms beim p95. Sechs erfundene Fälle liefen je fünfmal durch, mit 68 Kategorien zur Auswahl. Gemessen haben wir unseren Adapter samt API-Aufruf. Das Laden der Historie und das Speichern der Transaktion liegen außerhalb des Timers.
- Lernt Jev aus Kundenkorrekturen?
- Wir geben bis zu fünf passende frühere Entscheidungen derselben Firma mit. Neu gespeicherte Korrekturen stehen damit für den nächsten Aufruf bereit. Das Modell selbst wird dabei nicht neu trainiert. Wie viel das hilft, müssen wir noch an unabhängigen Fällen messen.
- Was passiert, wenn Jev unsicher ist oder die API ausfällt?
- Bei aktivierten KI-Vorschlägen und verfügbaren Kategorien übernehmen wir eine gültige Auswahl auch bei geringer Sicherheit. Bei Fehlern wählen wir lokal eine Ersatzkategorie, meist die allgemeine Ausgaben- oder Einnahmenkategorie. Kunden können den Vorschlag prüfen; Umsatzsteuer und Abschluss der Buchung bleiben eigene Schritte.
Norman übernimmt die operative Arbeit im Hintergrund
Von Rechnungen bis Buchhaltung: Norman organisiert wiederkehrende Finanzarbeit, damit du Fristen sauber einhältst und weniger manuell nachhalten musst.